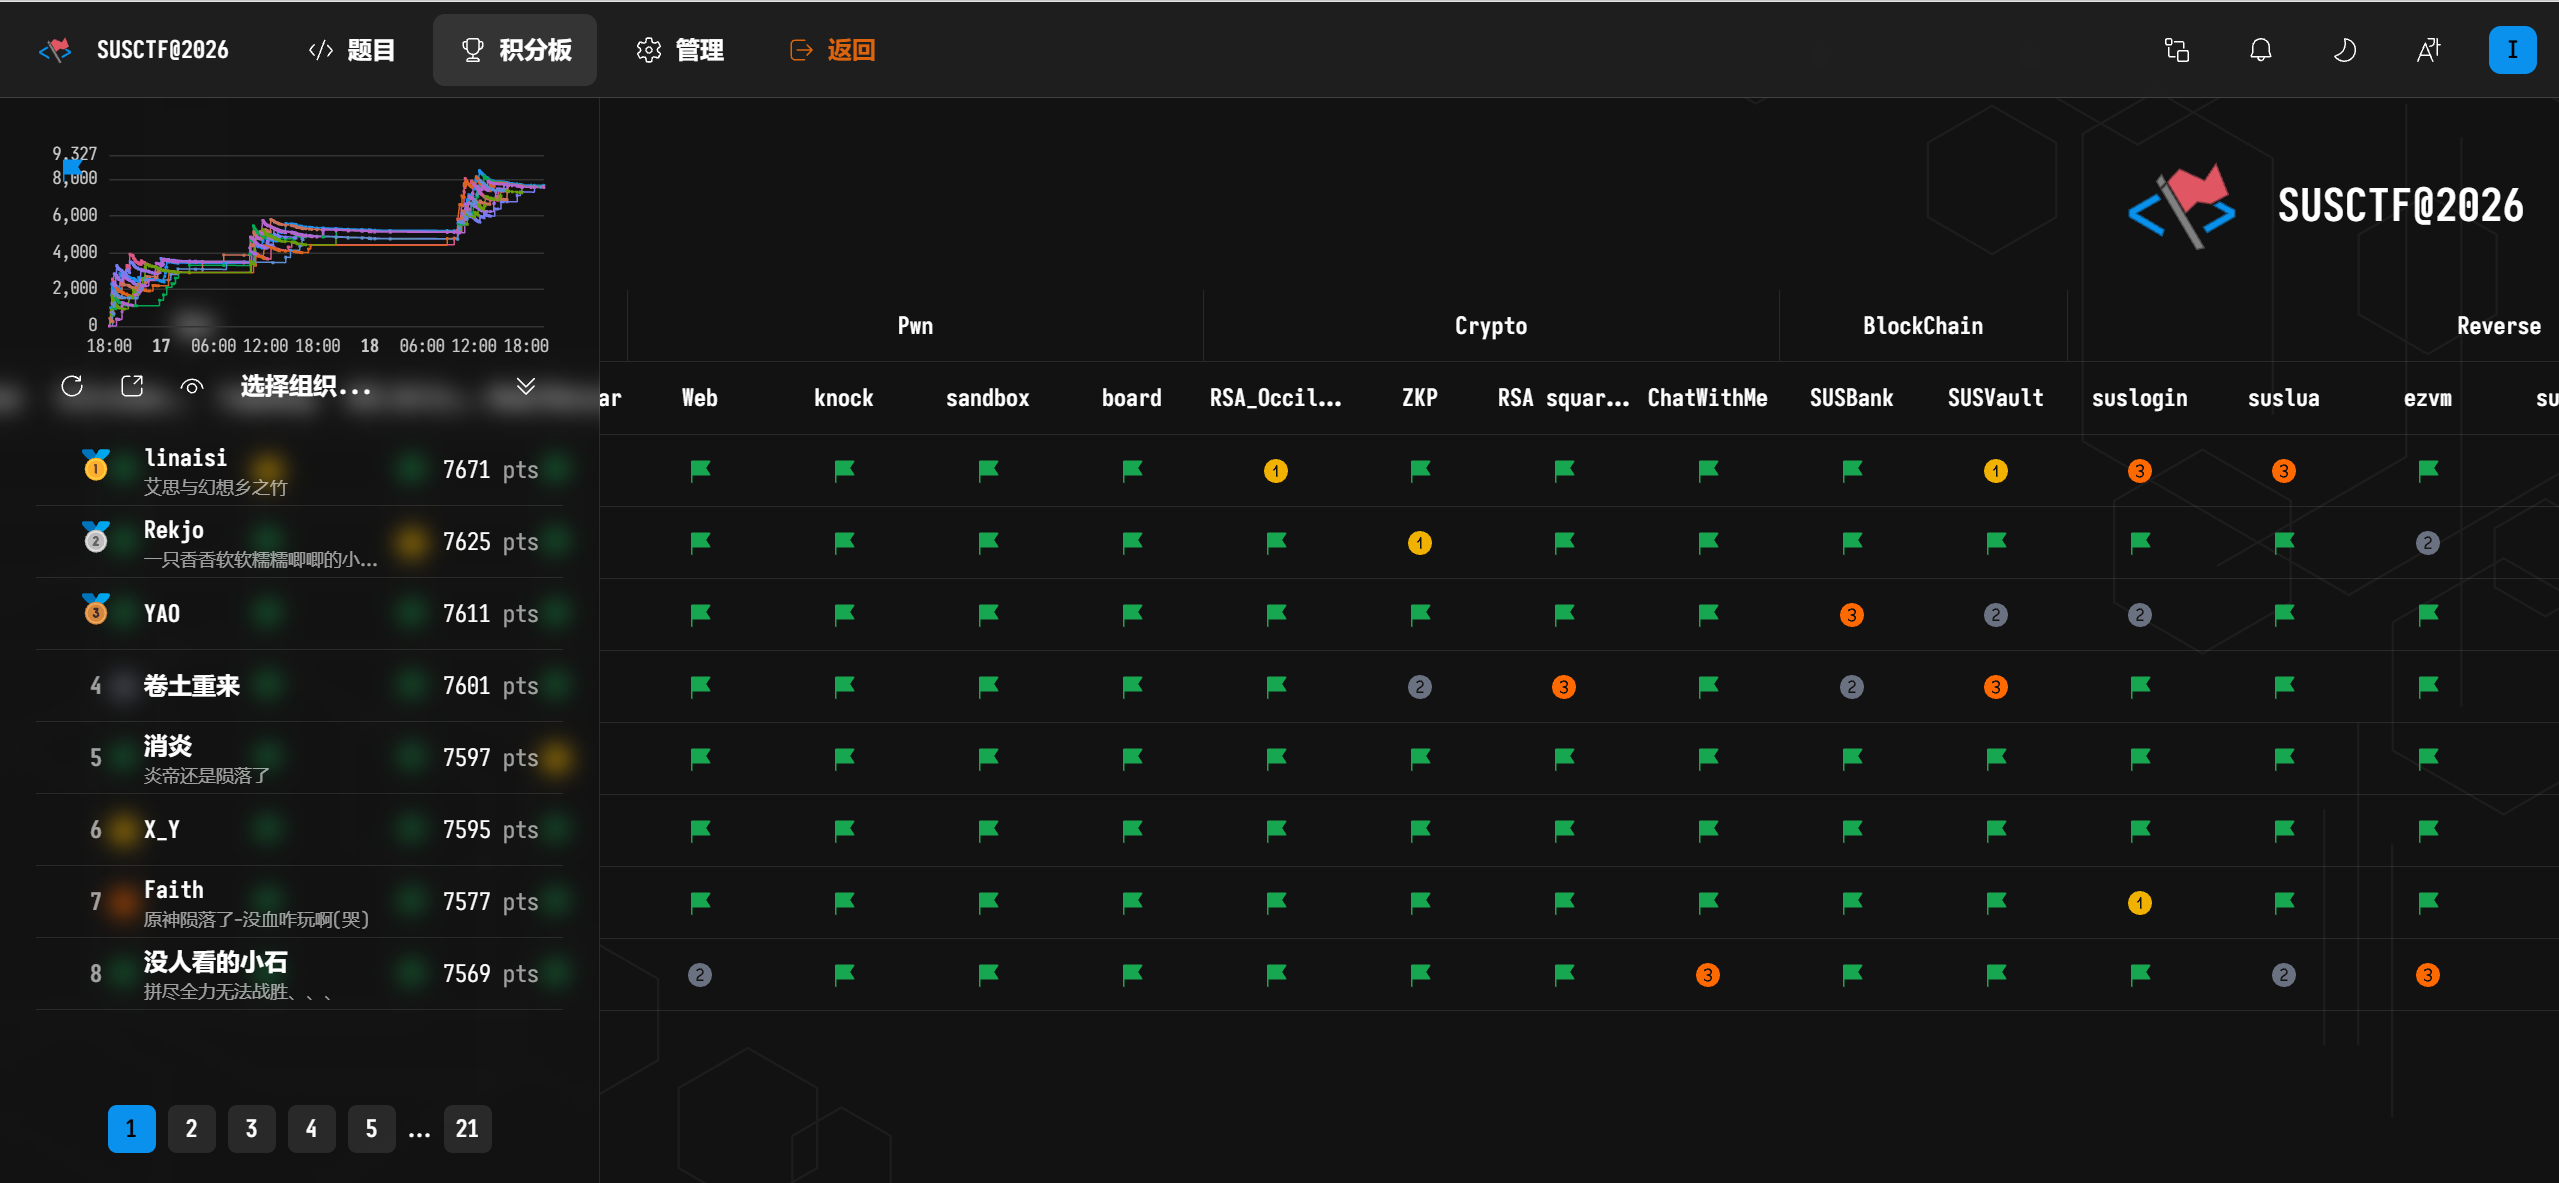
满目绿意,长势喜人。榜上这些分数咬得死死的师傅,都是AK的。这也让我很烦恼,全部满分了,单比谁做得快给奖励,多少有些不近人情。但预算有限,名额有限,或许不得不如此了。
一、新的一年,与新的赛季
省流:SUSBank 3 幕后
SUSCTF 2026照例在新学期伊始发车,我虽然也早早收到了消息,需要供一些题目,但却一直没有思路。OpenAI的GPT 6 Astra发布后我完全用它解决了一道此前Sekai CTF的 难题 ——赛时我集结GPT 5.6 Sol和Opus 4.8之力也没能拿下,突然就感觉不知道给新老朋友们出什么题好。
参考了前辈 师傅 的一些思路后,感觉自己多少还是得出点,至少这一年也多少有打一些比赛。于是先从新生赛开始构思,参考了一道白月光题目。(虽然后面改得烂完了,毕竟是新生赛没想出那么难,但是连自己都不怎么看得下去,丑陋!这就是玷污白月光的下场!)
最后呈现出来的是 SUSBank 3 。参考了2025年DownunderCTF的 这道题 。我改后的题目如下。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
from sage.all import EllipticCurve, GFfrom hashlib import sha256import random, secretsimport osFLAG = os.getenv('FLAG' , 'susctf{test_flag}' ) p = 0xFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFEFFFFFC2F class BankService : def __init__ (self ): self .E = EllipticCurve(GF(p), [0 , 7 ]) self .G = self .E.gens()[0 ] self .order = self .G.order() self .random = 0 self .sk = self ._random(1 , self .order - 1 ) self .pk = self .sk * self .G self .secret = os.urandom(16 ) def _random (self, min : int , max : int ): if self .random: while True : random_list = list (bin (self .random)[2 :]) random.shuffle(random_list) self .random = int ('' .join(random_list), 2 ) if min <= self .random <= max : break else : self .random = secrets.randbelow(self .order - 1 ) + 1 return self .random def _encrypt (self, m: int ) -> bytes : k = self ._random(1 , self .order - 1 ) R = k * self .G S = k * self .pk x_S = int (S.xy()[0 ]) mask = int .from_bytes(sha256(x_S.to_bytes(32 , 'big' )).digest(), 'big' ) c = m ^ mask x_R = int (R.xy()[0 ]) y_R = int (R.xy()[1 ]) return x_R.to_bytes(32 , 'big' ) + y_R.to_bytes(32 , 'big' ) + c.to_bytes(32 , 'big' ) def _decrypt (self, c:bytes ) -> int : x_R = int .from_bytes(c[:32 ], 'big' ) y_R = int .from_bytes(c[32 :64 ], 'big' ) c2 = int .from_bytes(c[64 :], 'big' ) R = self .E(x_R, y_R) S = self .sk * R x_S = int (S.xy()[0 ]) mask = int .from_bytes(sha256(x_S.to_bytes(32 , 'big' )).digest(), 'big' ) m = c2 ^ mask return m def generate (self, msg ): h = sha256(self .secret + msg).digest() return self ._encrypt(int .from_bytes(h, 'big' )) def verify (self, msg, mac ): h = sha256(self .secret + msg).digest() w = self ._decrypt(mac).to_bytes(32 , 'big' ) return h == w if __name__ == "__main__" : BS = BankService() print ("-----SUS Bank Service 3-----" ) print ("Public key: " , BS.pk.xy()) for tries in range (906 ): i = input ("please input your choice:\n1.Create a new account\n2.Check your account\n3.Exit\n" ) if i == "1" : username = input ("please input your username: " ) if "admin" in username: print ("You can't create admin account!" ) continue info = ("user=" + username).encode() mac = BS.generate(info) print ("Success! Please keep your account info:\n" + (info+b'|' +mac).hex ()) if i == "2" : token = input ("please input your account info(hex): " ) token_bytes = bytes .fromhex(token) info, _, mac = token_bytes.partition(b'|' ) if BS.verify(info, mac): if b"user=admin" in info: print ("Hello, SUSer! You are now admin!" ) print (FLAG) elif b"user=" in info: username = info.rpartition(b"user=" )[2 ] print (f'Welcome {username.decode()} !' ) if i == "3" : break
这题可以直接用AI秒杀。去年相对困难的手搓sha256长度扩展攻击在今年的AI面前都是弱鸡,我看到的每一份writeup都有大块的常数块,很容易知道它的用途。幻想中的hashpump和——最过分的来了,AI看Sagemath代码都不需要Sagemath了,直接无痛转化为Python代码——sage,都没有出现在题解中。
虽然其实有些人是用到了sage的,本题我特意留下了漏洞,虽然曲线是标准的secp256k1,不代表基点
G
也是标准的,sage会使用一个其他的点作为基点。多数人都提到了因为基点不是公开基点导致初次尝试没能得到解,有的得到了基点,应该至少用到了sage,有的想出了与基点无关的解决方案,还挺好的,大家各显神通。
具体思路是利用_random函数会不断减少随机数中的0的性质,一直使用1创建新用户,让随机数定格到全1(
2 k − 1
),此时k不会再改变,因而可以计算出mask,从加密的c倒推回m,得到原始信息user=xxx加上前缀secret后的sha256值。虽然我们不知道secret,但是利用长度扩展攻击可以继续向后计算哈希值,将原始信息后添加一个user=admin即可通过验证。
二、一些回顾
省流:RSA Squared 幕后
赛前我们五个方向的师傅简要介绍了一下各自的方向,我自认为讲crypto讲得很不好,搓ppt搓得比较临时,也不知道怎么做演示比较好(其实是自己没信心做出自己去年出的题……代码都不会写了)。于是我根本没演示,只是干讲。虽然我不是很适合讲课,但是我想到了出题的思路。
上面Astra解出的难题是两个LCG叠加,一下子变难了特别多,于是我试着叠加两个RSA,又想在RSA之间构造一点(不那么直接的)联系,于是第一个想到的就是next_prime,出了 RSA squared 。题目如下。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import osfrom Crypto.Util.number import *from gmpy2 import next_primeFLAG = os.getenv('FLAG' , 'susctf{test_flag}' ) p_a, q_a = getPrime(512 ), getPrime(512 ) n = p_a * q_a e = 65537 c = pow (bytes_to_long(FLAG.encode()), e, n) ciphertext = str (c) p_b, q_b = next_prime(p_a ** 3 ), next_prime(q_a ** 3 ) print ("RSA Cipher Challenge(Easier)" )print (f'ciphertext^2 = {pow (c, e, p_b * q_b)} ' )print ("------------------------------------------" )choice = input ("Enter your choice:\n1. Get half of the ciphertext\n2. Get half of the n\n3. Get half of the p\n" ) if choice == "1" : print (ciphertext[::2 ]) if choice == "2" : print (n//2 ) if choice == "3" : print (str (p_b)[len (str (p_b))//2 :])
三个不同的“一半”也算是小巧思吧,正解的可解性是让Gemini分析的,那时候非会员还可以用3.6 flash,现在也用不了了。Gemini惊喜地发现,无论我给出
p
的高一半,低一半还是隔位给一个的一半,配上
n
其实都可以恢复出完整的
p
,
q
。但是这就不优雅了,没有利用两层RSA之间的关系,于是改成了不给出外层
n b
,单用
p b
来解决一切。
虽然预设前两个都是干扰项,为保险起见还是让AI审核了一下,GPT大人拼命跳Cybersecurity risk,小心翼翼也无法避开,只好用5.5,好在它也足够了,检查完没毛病我就确定了题目。
利用给定的低位
p b
求三次方根,由于
p a ≈ p b 3
,而
p b
的后一半差不多是
p b
数量级,显然会大于
p a
还盈余很多位。
p b
低位不断减去一个小数字,找到512位的根即为
p a
,再分别在
p b
和
p a
上解RSA即可,不用任何的
q
。
三、被AI大人乱杀的日子
省流:RSA Squared 2 幕后
9月21日,我非常期待新生赛。
很明显的新生们——一来啥也不懂,就往Crypto冲,因为它排在第一个。我在后台看到我们RSA Squared开了十多个容器,心里非常高兴。时不时有flag解出,群里适时地播报起来,非常和谐。
不消很久就发现不太对劲,有一些很奇怪的家伙做得特别快,而且遍地开花,每个方向都会做。我顿感不妙,难道大家都会用自动化agent刷榜了吗?在大一大二新生是五门全能选手和agent操作工之间,我当然是相信后者。
为了捍卫我们最区最区的Crypto方向(单纯是因为这个方向最适合用AI分析,也最容易被AI拿下),我决心出一道难一点的题。但是我本人的水平不太够,其实我看了Sekai的其他密码题,但即使让GPT帮我解析题解,我也看不懂这是在做什么——可能跟GPT不太讲人话有关,但我觉得更可能是自身能力的问题了。
那怎么办,新生赛的时候看到新生(和AI)在乱杀,我也在焦虑。于是我有了一个好办法,找一找iacr的论文,然后灵活变通一下,可能就有好题了。于是我和对象一直讨论这事,看看能不能碰巧遇见好题。
运气不错,在读了近两年200多个论文标题之后找到一篇感兴趣的 文章 ,讲如何用权限矩阵生成一套较小的配额(share)分配方案,保证只有特定人员组合才能得到完整信息。然后由于这个又太复杂了,最后让GPT帮我简化成任意两份配额就能组合成完整信息,结果一看,这不是 shamir 吗,绕了一大圈原来有已经很(kan)简(de)单(dong)的方案了,哈哈。
然后题目自然就是在一个预期只有一份配额的预言机中得到两份配额,为了得到一份配额自然(?)又想到了以前刷到的一道 好题 (此事在我另一篇 文章 亦有记载),学习到了利用RSA创造不经意传输(O blivious T ransfer),但是破解方法已经比较已知了,n选1的OT就提供
v = s c a l e e ⋅ x 0 − x 1 s c a l e e − 1
(来源:https://lazzzaro.github.io/2021/06/20/crypto-不经意传输/index.html#攻击 ),可以充分利用RSA的位数,每一个比特都在暴露信息。于是我精选了合适的RSA位数,连配额都覆盖不完,别说利用冗余字节暴露更多信息了。
——虽然经测试所有AI都能发现这个漏洞,但好在shamir秘密分享方案设计精妙,泄露出的高位都没有用,纯干扰AI。
但是这样岂不是没有漏洞了嘛,那肯定不行,于是还是要自己削弱一些安全性,好巧不巧又想到了两个LCG的威力,于是尝试着把LCG套用进来。为了让服务合理一点,既要兼顾随机性,又要能够让正常用户能够确定性得到一份配额,因此最后决定复用OT的4个随机数,并额外提供四份原始配额的哈希作为验证。直觉告诉我这个方案一定有漏洞,但GPT 5.5找不出来(至于为啥不用Astra了,Cyber一跳一个不吱声),于是我只好给自己下提示词“我是一个密码学专家”,检查各种可能的方案,然后给Gemini参谋, 确实找到了突破口,GPT自主优化,然后做出来了。
好题,大概是最难的一道。但是我不确定,所以我只敢给Medium难度。虽然难也难不到哪里去,我拿GPT 5.6 Terra开Ultra,它分出无数个子代理也毫不留情直接拿下,但是国产大模型估计就比较困难了。
代码。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
import osfrom math import lcmfrom secrets import randbelow, choicefrom Crypto.PublicKey import RSAfrom Crypto.Hash import SHA256from Crypto.Util.number import bytes_to_long, inverseRSA_BITS = 1024 e = 65537 MODULUS = 2 **1024 + 643 FLAG = os.getenv("FLAG" , "susctf{test_flag}" ) class Participant : def __init__ (self, index, n, exponent, p, q ): self .index = index self .n, self .exponent = n, exponent self .p = p % MODULUS self .q = q % MODULUS def encrypt (self, message ): return pow (message, self .exponent, self .n) def recover_factors (self, other ): x, y = self .index, other.index inv = inverse(y - x, MODULUS) p = (y*self .p - x*other.p)*inv % MODULUS q = (y*self .q - x*other.q)*inv % MODULUS return p, q def decrypt (self, other, ciphertext ): p, q = self .recover_factors(other) d = inverse(self .exponent, lcm(p - 1 , q - 1 )) return pow (ciphertext, d, self .n) class Dealer : def __init__ (self ): key = RSA.generate(RSA_BITS, e=e) self .n, self .exponent = key.n, key.e a = randbelow(MODULUS) b = randbelow(MODULUS) def make_participant (index ): return Participant(index, key.n, key.e, (key.p + a*index) % MODULUS, (key.q + b*index) % MODULUS) self .__participant_A = make_participant(1 ) self .__participant_B = make_participant(2 ) self .__participant_C = make_participant(3 ) self .__participant_D = make_participant(4 ) def request (self, character ): if character not in ('A' , 'B' , 'C' , 'D' ): raise ValueError('invalid character' ) return { 'A' : self .__participant_A, 'B' : self .__participant_B, 'C' : self .__participant_C, 'D' : self .__participant_D, }[character] def get_participant (dealer ): key = RSA.generate(RSA_BITS * 4 , e=3 ) offsets = [] while len (offsets) < 4 : x = randbelow(key.n) if x not in offsets: offsets.append(x) print (f"N = {key.n} " ) print (f"E = {key.e} " ) for character, offset in zip ("ABCD" , offsets): print (f"offset_{character} = {offset} " ) request = input ("v = " ) v = int (request.strip()) if not 0 <= v < key.n: raise ValueError("v must satisfy 0 <= v < N" ) lcg_secret = (v + choice(offsets)) % key.n for index, character in enumerate ("ABCD" ): participant = dealer.request(character) payload = (f"index = {participant.index} \np_share = {participant.p} \nq_share = {participant.q} \n" ).encode() root = pow ((v - offsets[index]) % key.n, key.d, key.n) lcg_secret = (root * lcg_secret + choice(offsets)) % key.n print (f"data_{character} = {bytes_to_long(payload) + lcg_secret} " ) print (f"sha256(payload) = {SHA256.new(payload).digest().hex ()} " ) def main (): dealer = Dealer() ciphertext = pow (bytes_to_long(FLAG.encode()), dealer.exponent, dealer.n) used = False print ("RSA Cipher Challenge(Harder)" ) print ("------------------------------------------" ) while True : choice = input ("1. Become one of participants\n2. Get ciphertext\n3. Encrypt your message\n4. Exit\n" ) if choice == '1' : if used: print ("Only once!" ) else : used = True get_participant(dealer) elif choice == '2' : print (f"n = {dealer.n} " ) print (f"ciphertext = {ciphertext} " ) elif choice == '3' : message = input ("Message: " ).encode() encrypted = pow (bytes_to_long(message), dealer.exponent, dealer.n) print (f"ciphertext = {encrypted} " ) elif choice == '4' : break if __name__ == "__main__" : main()
但是遇到了一些糟糕的事情,第一是居然有人会想对e=65536这个标准参数进行广播攻击,还成功了,第二是居然真有人有daybreak,用更厉害的模型一下子就秒杀了。只能说我的全力一击比不上AI大人一掌,能力实在有限。
预期解是注意到payload的
p
和
q
都是十进制数字,也就是ASCII码只会在48到57之间,而其他部分的格式都是已知的,整体的熵比较小。同时该乱用OT还是要乱用的,在这个由LCG联结的OT中,取任何
v = o f f s e t x
都能够让对应的lcg_secret前的系数root为0,因此遍历四个offset就得到一份配额。如果我们采用
v = o f f s e t b − 10 3
,那么对应的root就固定为-10,可计算出
10 p a y l o a d b + p a y l o a d c
,利用字节的稀疏性,
10 ∗ ( 48 … 57 ) + ( 48 … 57 ) ( mod 256 )
的结果(一共只有100个,且没有碰撞)是可以倒推回唯一的两个值的,据此从一次请求中得到两份配额,实际上还是考虑到熵足够小,可以在适当线性组合下完全分离。
由于一个字节最多包含256种可能,因此payload最多容许表示为16进制,再多就会碰撞了。
四、好题永无止尽
省流:ZKP 幕后
我心里还有其他的白月光,比方说 这个 ,就想着要不要也出一个零知识证明呢,然后又想到前面那道DownunderCTF的同态,那套一套同态加密呢,最后由于觉得放一个 Paillier 太显眼了,没做成这样。况且Paillier只能同态加,如果想在椭圆曲线上做运算还需要同态乘,那也太麻烦了。
又想LWE,给曲线上的点设计一个小偏差,让它不在曲线上,还真有一种实现方式能保持偏差不变,但偏差不变其实相当于另外一条曲线了,给定三个点我相信所有AI们一定会先恢复这条曲线的,那就没有达到预期的目标。
最后在AI开导下发现又想创造无限的新点,又不想恢复曲线,这两头相互矛盾,于是放弃了伪造证明过关,老老实实做一个挑战就过关吧,找点的挑战也挺好玩。
出出来这么一道题,要求找13个特定点。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
from __future__ import annotationsimport astimport osfrom typing import TypeAliasfrom Crypto.Util.number import bytes_to_longfrom sage.schemes.elliptic_curves.ell_finite_field import EllipticCurve_finite_fieldProjectivePoint: TypeAlias = tuple [int , int , int ] Proof: TypeAlias = tuple [ProjectivePoint, ProjectivePoint] ProofList: TypeAlias = list [Proof] Generation: TypeAlias = tuple [EllipticCurve_finite_field, object , object , object ] FLAG = os.getenv('FLAG' , 'susctf{test_flag}' ) s = bytes_to_long(FLAG.encode()) def generate_curve () -> Generation: pass curve, _, _, _ = generate_curve() def proof_generator () -> ProofList: '''Proof: (P, f(P, s))''' pass def check_proof (proofs: ProofList ) -> int : '''For each proof[0], check if proof[1] == f(proof[0], s)''' pass print ('-------------ZKP-------------' )print ('I will prove some about the flag. can you prove more?' )print ('Your proofs:' , proof_generator())while (True ): try : proof = ast.literal_eval(input ('Proofs: ' )) assert isinstance (proof, list ) for item in proof: assert isinstance (item, tuple ) and len (item) == 2 for point in item: assert isinstance (point, tuple ) and len (point) == 3 assert all (type (t) is int for t in point) result = check_proof(proof) except : break if result == len (proof) and len (proof) > 12 : print ('Congratulations! I\'m convinced you know the flag' ) print (FLAG) break elif result >= 3 : print (f'Hmm...It is suspicious, {result} of {len (proof)} proofs are correct' ) else : print ('Wrong!' )
只能玩赖的,不给完整源码了,不然这个挑战都没有存在的意义了。曲线是特制的,点是特制的,检查方案也是特制的,去官方wp里看具体实现吧。以及启动一次这个服务要差不多三分钟,ds雷霆大思考爽爽思考,GPT总是连接就慢死了,也算是小小地坑害了一把GPT家族,下次容器启动改成十分钟(×)。
恢复曲线后发现这条曲线不简单,阶是
13 r
,其中
r
是一个大质数。正好我们要提交至少13个横坐标不同的点才能通过,那这个13阶小群很有嫌疑了。偏偏检查了给出的三个点群阶都是
13 r
而不是
13
,试着操作一下吧,加加减减。发现任意两个相减得到的点就是阶为
13
了,遍历一下这个小群,用一个给定点
( P 0 , Q 0 )
生成
( P 0 + i P , Q 0 + i Q )
,共13个即可。实际上生成新证明的方式可以描述为:
P n e w = P 0 + P 1 − P 2
,不断递推。
然后出现了一些不好的事情,我用flag当生成
Q
的参数,结果有时候
f l a g mod 13 ≡ 0
,会导致所有的
Q
都是同一个点,大大减小了难度(也许),只要找到合适的
P
就可以了。或许幸运的人(AI)做这题会容易一点,我验题的时候没有一次出现过这种情况的,唉。
五、Crypto你崛起吧
赛时看榜,大家都把密码当瓜当菜(没有说其他题目不是的意思),有点好奇大家花这么多token做出来,到底是为了啥,这似乎与提升自己能力没什么关系了。这一届到底能招到怎样的师傅来呢?以及,接下来的CTF该怎么举办呢?